很多出海老板一听 GEO 就觉得像黑科技:要么被承诺「保证进 ChatGPT 答案」,要么被吓得去堆 llms.txt、批量造 FAQ 薄页。我陪外贸独立站排期时,更愿意把问题说死——**GEO 优化怎么做?先让 AI 搜索抓得到、读得懂,再给可核对的事实,最后用封存问题集反复采样证明有没有被引用。**Google Search Central 写得很清楚:生成式 AI 功能仍建立在核心搜索系统上,SEO 地基仍然相关;他们同时点名:不必为 Google 专门造 llms.txt 或「AI 专用 markup」。SEMrush 的 GEO 指南也把「可抓取 + 结构化回答 + 权威提及」放在同一条链上,而不是另起一套玄学。
本文按外贸独立站语境,把熊猫出海那套「问题集→监测」10 步改写成可落地流程,并单独回答三件常被问歪的事:要不要做 llms.txt、如何放行 OAI-SearchBot、事实库和营销文案怎么分。不承诺任何引用率或询盘数字。
1. 先定问题集与基线,再谈优化动作
短答:没有封存问题集,后面所有「被引用了」都不可复核。
我给工厂/品牌站的起步动作很朴素:
- 从买家会问 AI 的句子出发,而不是从「我想冲哪个大词」出发。品类词、场景词、比较词、风险词、决策词各列几条英文原句——很多直接来自询盘邮件与 WhatsApp。
- 封存版本号与日期。基线做完前不要偷偷改问法;否则你无法区分「内容进步」和「问题换了」。
- 在目标引擎逐条提问并截图存档:ChatGPT 搜索、Google AI Overviews / AI Mode、Perplexity 至少各跑一轮;记录是否提及品牌、引用了哪条 URL、事实是否被说歪。
- 接受「单次查询不作效果证明」。正式对比至少跨多个时间窗口复测——这一纪律比任何工具仪表盘都重要。
Ahrefs 反复强调:AI 搜索优化的前提仍是页面可访问、事实可抽取;SEMrush 的 AI visibility audit 也从「基线可见度」起算。外贸站若跳过这一步,很容易把偶然一次被点名当成「GEO 做成了」。
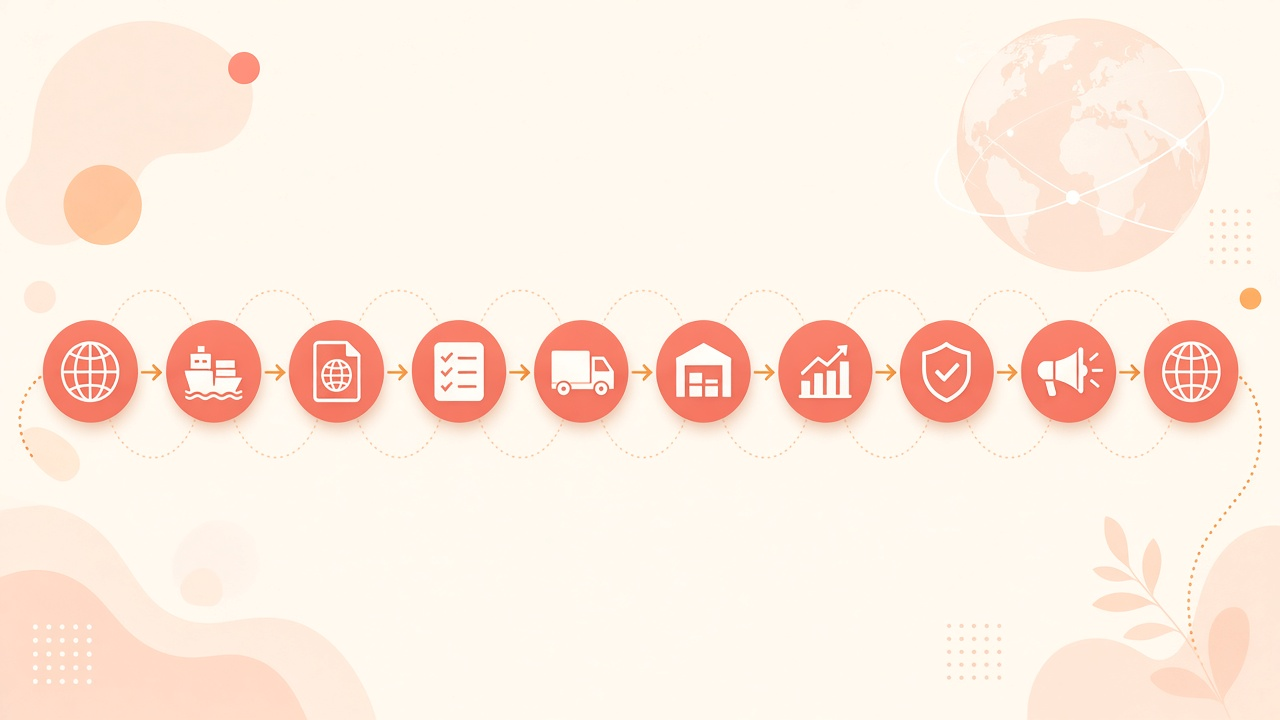
2. 十步流程怎么串成一条可验收链路?
短答:抓取准入 → 索引与文本化 → 事实资产 → 答案页与佐证 → 合规底线 → 监测迭代。
| 步序 | 动作 | 外贸独立站落地提示 |
|---|---|---|
| 1 | 建问题集 | 用采购原话,按品类/场景/比较/风险分桶 |
| 2 | 基线采样 | 多引擎截图;注明模型与日期 |
| 3 | 放行搜索类爬虫 | robots + CDN/WAF 一起查;训练 bot 可另议 |
| 4 | 确保被索引 | GSC 网址检查;更新页可推 IndexNow(Bing 生态) |
| 5 | 关键信息文本化 | 参数/交期/认证进 HTML,不只在 PDF/图片 |
| 6 | 建事实库 | 与营销文案分库;可核验字段带版本 |
| 7 | 写答案型页面 | 首段直接答;一页一意图 |
| 8 | 争取第三方佐证 | 行业媒体、目录、真实案例,重质量 |
| 9 | 避开操纵 | 不做隐藏文本、伪共识站群、保证首位 |
| 10 | 监测迭代 | 按封存问题集复测;误引先改事实库 |
Google 的 AI 优化指南把 RAG 与 query fan-out 讲成「系统仍从搜索索引取相关页」。因此第 3–5 步不是「GEO 附加项」,而是门票。主题怎么铺、怎么避免一问一薄页,可对照站内这篇:用内容集群建立供应商主题权威。更完整的概念边界,见 GEO(生成式引擎优化)指南。
3. 要不要做 llms.txt?
短答:对 Google 搜索(含生成式功能)不是必须;可作其他系统的可选清单,别神话成排名开关。
Google 明文:不需要为出现在 AI Overviews / AI Mode 新建机器可读文件或特殊 AI markup;即便你维护了 llms.txt,对 Google Search 既无助也不加分——它会忽略这类「专用文件」的特殊待遇。Ahrefs 学院侧也提醒:目前主流模型对 llms.txt 的官方支持仍然有限,别把精力从可抓取正文挪到「又一个根目录文件」。
我给外贸团队的实操口径:
- 若技术同学想维护一份「站点地图式摘要」方便内部或特定工具读取——可以,成本可控就做。
- 若代理把「没做 llms.txt」写成「所以你们没被 AI 引用」——这是叙事错误,优先查索引、渲染、事实冲突与权威信号。
- 永远不要用
llms.txt替代 Organization / Product 可见内容与诚实的 Schema。
4. 如何放行 OAI-SearchBot?
短答:在 robots.txt(以及 CDN/WAF)明确允许搜索索引用的爬虫;训练用 GPTBot 可单独决策,两者不要混为一谈。
OpenAI 把用途拆开:OAI-SearchBot 服务 ChatGPT 搜索引用;GPTBot 偏训练抓取。熊猫出海转述的官方要点也一致——屏蔽 OAI-SearchBot 的站点不会出现在 ChatGPT 搜索答案里;你仍可选择屏蔽 GPTBot。Google 侧 AI 功能主要跟 Googlebot 规则走,别误以为「禁了 Google-Extended 就禁了 AI Overviews」。
排查清单(按优先级):
- 打开
/robots.txt,找Disallow是否误伤OAI-SearchBot、PerplexityBot、Googlebot。 - 查 Cloudflare / 其他 WAF 的「AI Scrapers」默认规则——很多站问题出在边缘拦截,不在 robots。
- 用服务器日志或 Bot Analytics 看搜索类 bot 是否 200;403/超时优先修。
- 训练 bot 策略写进合规备忘:法务若要求禁训练,单独禁 GPTBot 等,并文档化,避免「一刀切全禁」。
5. 事实库和营销文案怎么分?
短答:事实库只收可核验字段;营销文案可讲故事,但凡写到数字与规格,必须以事实库版本为准。
| 库别 | 放什么 | 禁止什么 |
|---|---|---|
| 事实库 | 型号、材料、公差、认证编号、MOQ、标准交期、电压/插头版本、测试口径 | 「业界领先」「最可靠」无证据形容词 |
| 观点库 | 选型建议、应用取舍、工程师经验判断 | 把观点写成不可推翻的规格 |
| 营销表达 | 品牌叙事、场景故事、活动话术 | 擅自改写事实库数字 |
落地到官网:规格页 / FAQ / 下载区引用同一主数据;博客可以讲案例,但参数句必须可回链到事实页。SEMrush 强调含引用与统计的内容更容易被生成式答案「捞」——前提是这些数字经得起交叉核对。外贸站最常见的翻车是:中文报价单、英文产品页、PDF 手册三套功率互相打架,AI 随便摘一段就变成「你们自己打脸」。
答案型页面写法(第 7 步)可压缩为:首段直接答 → 表格对比 → 边界条件 → 可见更新日期。技术侧的抓取与速度底座,可与站内 外贸网站SEO推广三轨SOP 对照排期,避免 GEO 项目和技术债并行失控。
6. 监测怎么做才不算自嗨?
短答:按封存问题集做多窗口复测,并同时看 GSC/引荐与「答案准确性」,而不是只看有没有被点名。
可执行月度仪式:
- 同一问题集,在同一组引擎复问;记录品牌提及、引用 URL、错述类型。
- GSC:生成式相关流量若可见,按官方口径观察,不编造私有基线。
- GA4:查看 chatgpt.com、perplexity.ai 等引荐会话与转化事件(有就记,没有别硬凑)。
- 误引优先改事实库与对应落地页,再考虑补第三方来源。
- 模型大版本升级后,重建基线——旧截图只作历史,不作新结论。
第 9 步底线再强调一次:隐藏指令、站群伪共识、伪造榜单、承诺「保证 AI 首位」——既碰 Google 垃圾政策,也毁 E-E-A-T。GEO 是工程,不是话术。
7. 常见问题
GEO 和 SEO 是两套预算吗?
对 Google 而言不是。AI Overviews / AI Mode 仍依赖核心搜索与索引质量;GEO 额外强调可引用事实、第三方佐证与问题集监测。预算上应看成「同一地基上的摘录层」,而不是二选一。
屏蔽 GPTBot 还会被 ChatGPT 搜索引用吗?
按 OpenAI 的爬虫分工说明,训练用 GPTBot 与搜索用 OAI-SearchBot 设置相互独立:放行 OAI-SearchBot、屏蔽 GPTBot,仍可能进入 ChatGPT 搜索引用池。以你站点 robots 与官方文档最新版为准。
十步要一次做完吗?
不必。优先顺序通常是:问题集与基线 → 爬虫/索引/文本化 → 事实库与 3–5 个答案页 → 监测。第三方佐证可并行,但不要在机器还抓不到正文时先砸公关预算。
多久能看到「被引用」?
没有统一 SLA。抓取与索引周期、品类竞争、第三方来源积累都会影响。按多时间窗口复测再下结论;任何「保证 N 天进答案」的承诺都应警惕。